Datos de muestra
Un Manhattan plot es un tipo de gráfico de dispersión que se utiliza para mostrar los resultados de un estudio de asociación del genoma completo (GWAS). Cada punto es una variante genética (SNP), el eje X representa su posición a lo largo de los cromosomas y el eje Y el -log10 de su p-valor, de modo que las variantes más significativas aparecen como picos, como los rascacielos de Manhattan.
Los datos deben contener una columna con el cromosoma (CHR), otra con la posición de la variante dentro del cromosoma (BP) y otra con el p-valor (P). En este tutorial utilizamos datos simulados para 22 cromosomas con dos picos de asociación. El paquete qqman también proporciona un conjunto de datos de muestra llamado gwasResults con la misma estructura.
set.seed(3)
gwas <- do.call(rbind, lapply(1:22, function(chr) {
  n <- 2500 - chr * 40
  data.frame(SNP = paste0("rs", chr, sprintf("%04d", 1:n)),
             CHR = chr,
             BP = sort(round(runif(n, 1, (200 - chr * 3) * 1e6))),
             P = runif(n))
}))
Posición acumulada de las variantes
Las posiciones de las variantes vuelven a empezar al inicio de cada cromosoma, por lo que para colocar todos los cromosomas uno detrás de otro a lo largo del eje X tendrás que calcular una posición acumulada. Para ello, calcula la longitud de cada cromosoma y suma la longitud de todos los cromosomas anteriores a la posición de cada variante.
# install.packages("dplyr")
library(dplyr)

gwas_cum <- gwas |>
  group_by(CHR) |>
  summarise(max_bp = max(BP)) |>
  mutate(bp_add = lag(cumsum(as.numeric(max_bp)), default = 0)) |>
  select(CHR, bp_add)

gwas <- gwas |>
  inner_join(gwas_cum, by = "CHR") |>
  mutate(BP_cum = BP + bp_add)
Además, calcula el centro de cada cromosoma, ya que lo necesitarás para colocar las etiquetas del eje X.
axis_set <- gwas |>
  group_by(CHR) |>
  summarize(center = mean(BP_cum))
Manhattan plot básico
Ahora puedes crear el Manhattan plot pasando la posición acumulada a x y -log10(P) a y. Para diferenciar los cromosomas es habitual alternar dos colores, lo que se consigue pasando CHR %% 2 (el resto de dividir el número del cromosoma entre dos) a color.
ggplot(gwas, aes(x = BP_cum, y = -log10(P), color = as.factor(CHR %% 2))) +
  geom_point() +
  scale_color_manual(values = c("#264653", "#2A9D8F"))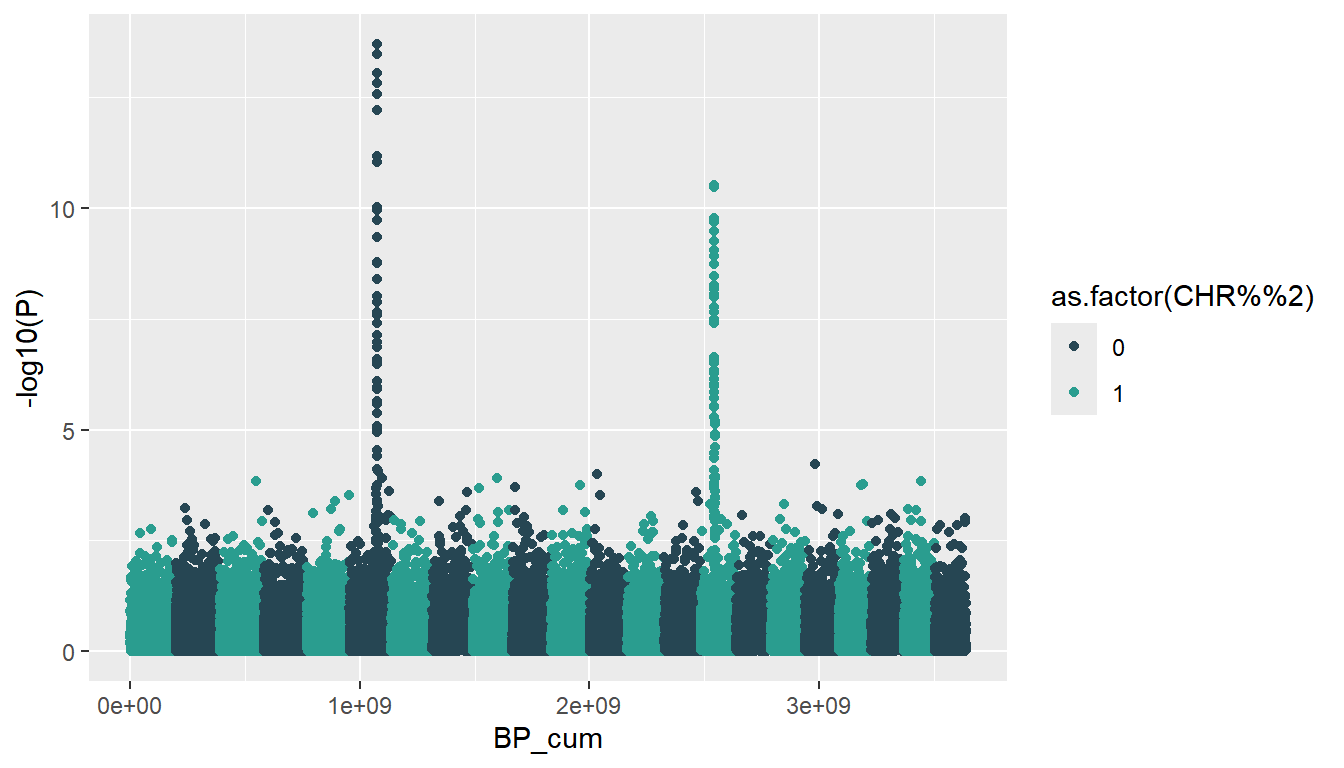
Cromosomas en el eje X
El eje X del gráfico anterior muestra las posiciones acumuladas, que no aportan información. Puedes sustituirlas por el número de cada cromosoma pasando los centros que calculamos antes al argumento breaks de scale_x_continuous y los cromosomas a labels. Consulta la guía sobre los ejes en ggplot2 para más opciones de personalización.
ggplot(gwas, aes(x = BP_cum, y = -log10(P), color = as.factor(CHR %% 2))) +
  geom_point() +
  scale_color_manual(values = c("#264653", "#2A9D8F")) +
  scale_x_continuous(breaks = axis_set$center, labels = axis_set$CHR)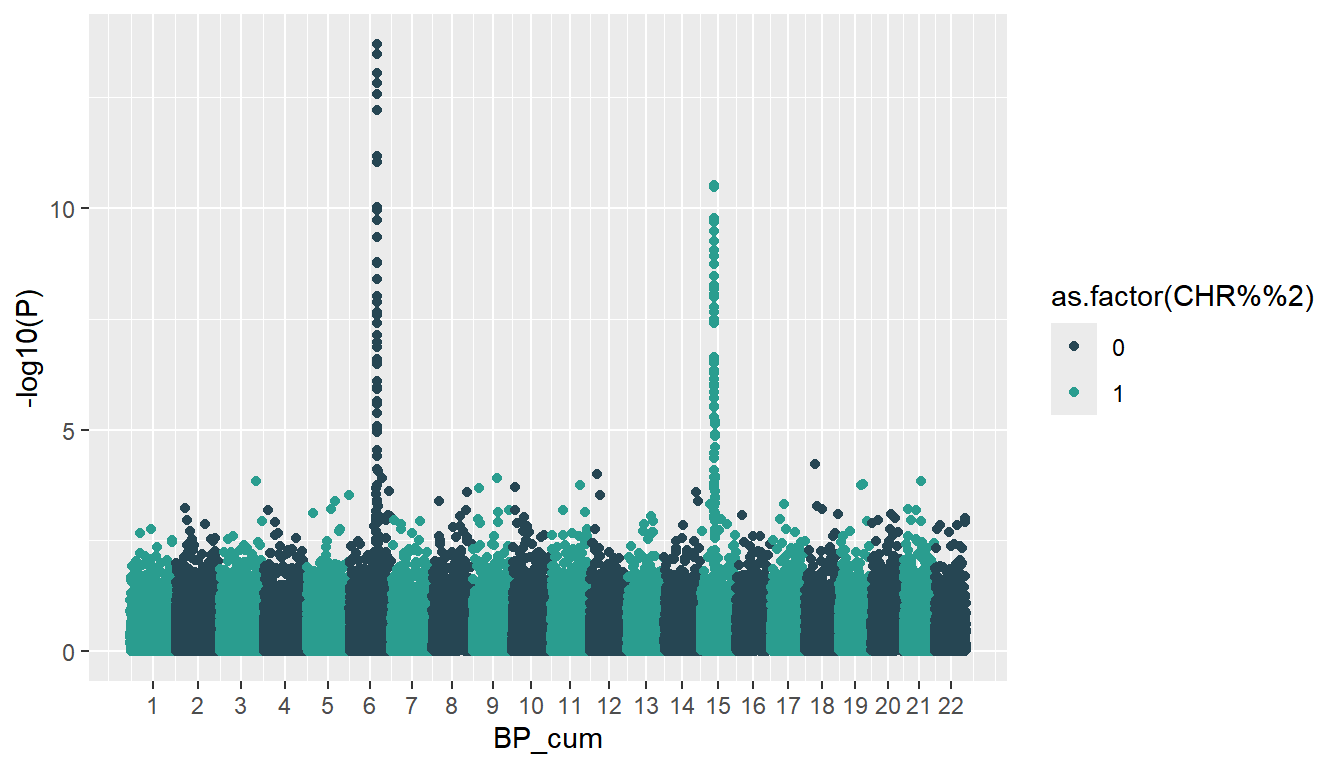
Líneas de significación
El umbral de significación a nivel genómico se suele establecer en un p-valor de 5e-8 y el umbral sugestivo en 1e-5. Puedes añadir ambos como líneas horizontales con geom_hline, recordando transformarlos con -log10.
ggplot(gwas, aes(x = BP_cum, y = -log10(P), color = as.factor(CHR %% 2))) +
  geom_point() +
  geom_hline(yintercept = -log10(5e-8), color = "#E76F51", linetype = "dashed") +
  geom_hline(yintercept = -log10(1e-5), color = "grey50", linetype = "dashed") +
  scale_color_manual(values = c("#264653", "#2A9D8F")) +
  scale_x_continuous(breaks = axis_set$center, labels = axis_set$CHR)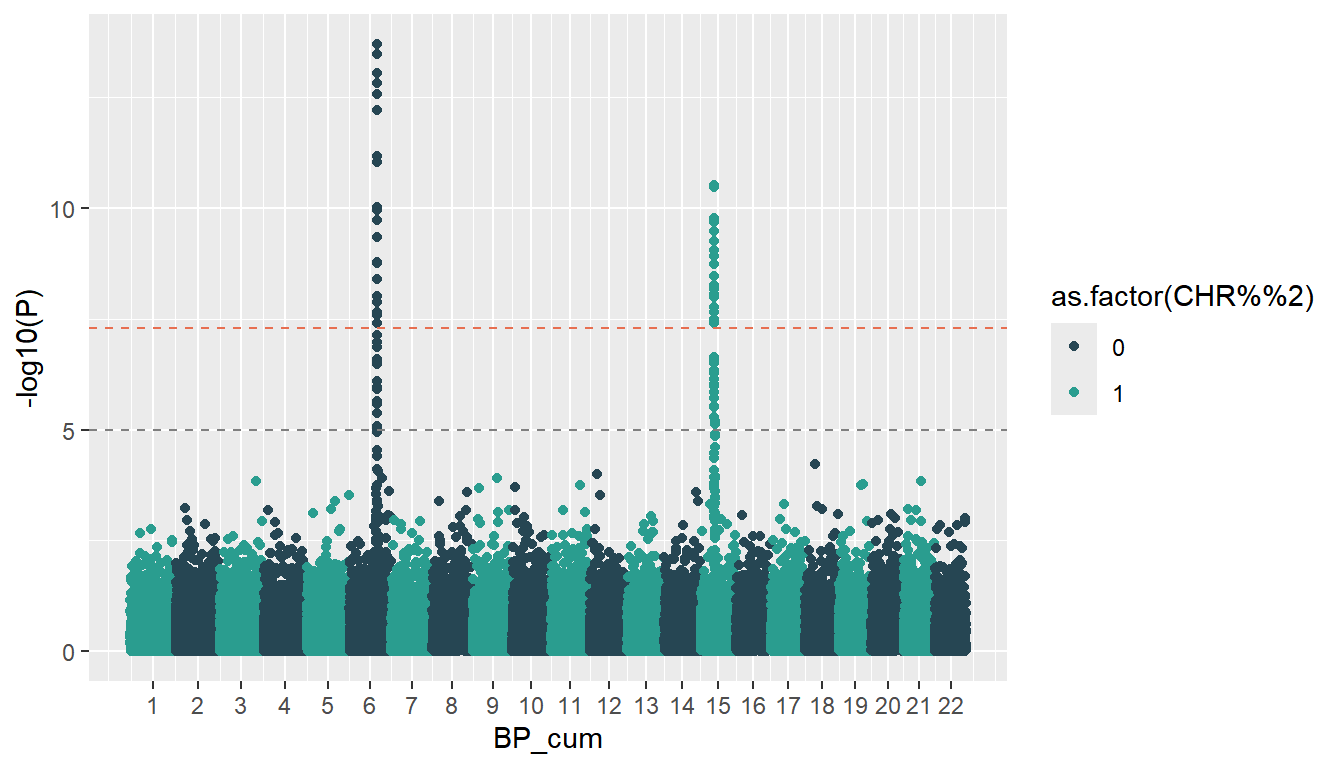
Etiquetar los SNPs principales
Para etiquetar las variantes más significativas, filtra las que superan el umbral genómico y quédate con la principal de cada cromosoma. Luego, añade sus nombres con geom_text_repel del paquete ggrepel, que evita que las etiquetas de texto se solapen.
# install.packages("ggrepel")
library(ggrepel)

top_snps <- gwas |>
  filter(P < 5e-8) |>
  group_by(CHR) |>
  slice_min(P, n = 1)

ggplot(gwas, aes(x = BP_cum, y = -log10(P), color = as.factor(CHR %% 2))) +
  geom_point() +
  geom_hline(yintercept = -log10(5e-8), color = "#E76F51", linetype = "dashed") +
  geom_hline(yintercept = -log10(1e-5), color = "grey50", linetype = "dashed") +
  geom_text_repel(data = top_snps, aes(label = SNP),
                  color = "black", nudge_y = 1) +
  scale_color_manual(values = c("#264653", "#2A9D8F")) +
  scale_x_continuous(breaks = axis_set$center, labels = axis_set$CHR)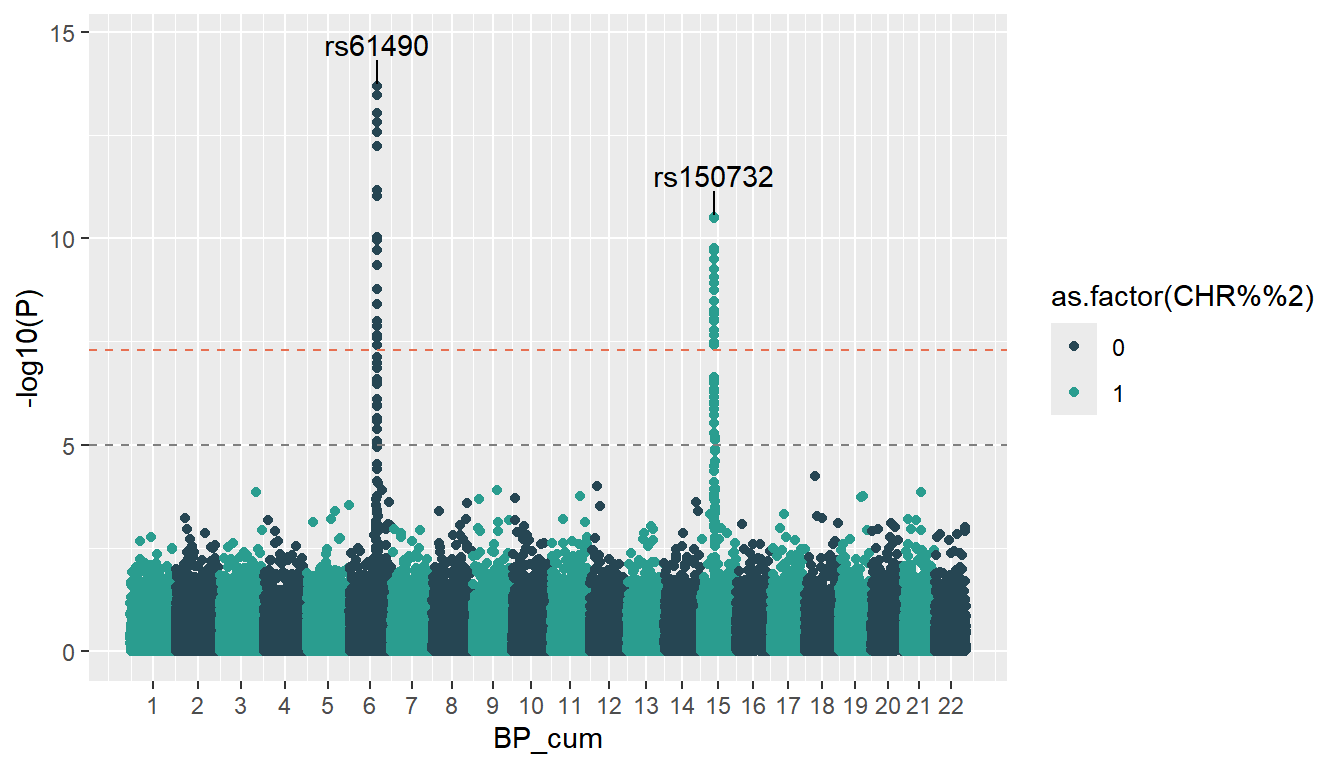
Personalización adicional
Por último, puedes eliminar la leyenda, que no aporta información, eliminar las líneas verticales del grid con la función theme, hacer que el eje Y empiece en cero con expand y establecer los títulos de los ejes. Ten en cuenta que expression permite escribir el subíndice del título del eje Y.
ggplot(gwas, aes(x = BP_cum, y = -log10(P), color = as.factor(CHR %% 2))) +
  geom_point(size = 0.8) +
  geom_hline(yintercept = -log10(5e-8), color = "#E76F51", linetype = "dashed") +
  geom_hline(yintercept = -log10(1e-5), color = "grey50", linetype = "dashed") +
  geom_text_repel(data = top_snps, aes(label = SNP),
                  color = "black", nudge_y = 1) +
  scale_color_manual(values = c("#264653", "#2A9D8F")) +
  scale_x_continuous(breaks = axis_set$center, labels = axis_set$CHR) +
  scale_y_continuous(expand = c(0, 0), limits = c(0, 16)) +
  theme_minimal() +
  theme(legend.position = "none",
        panel.grid.major.x = element_blank(),
        panel.grid.minor = element_blank()) +
  labs(x = "Cromosoma", y = expression(-log[10]~"p-valor"))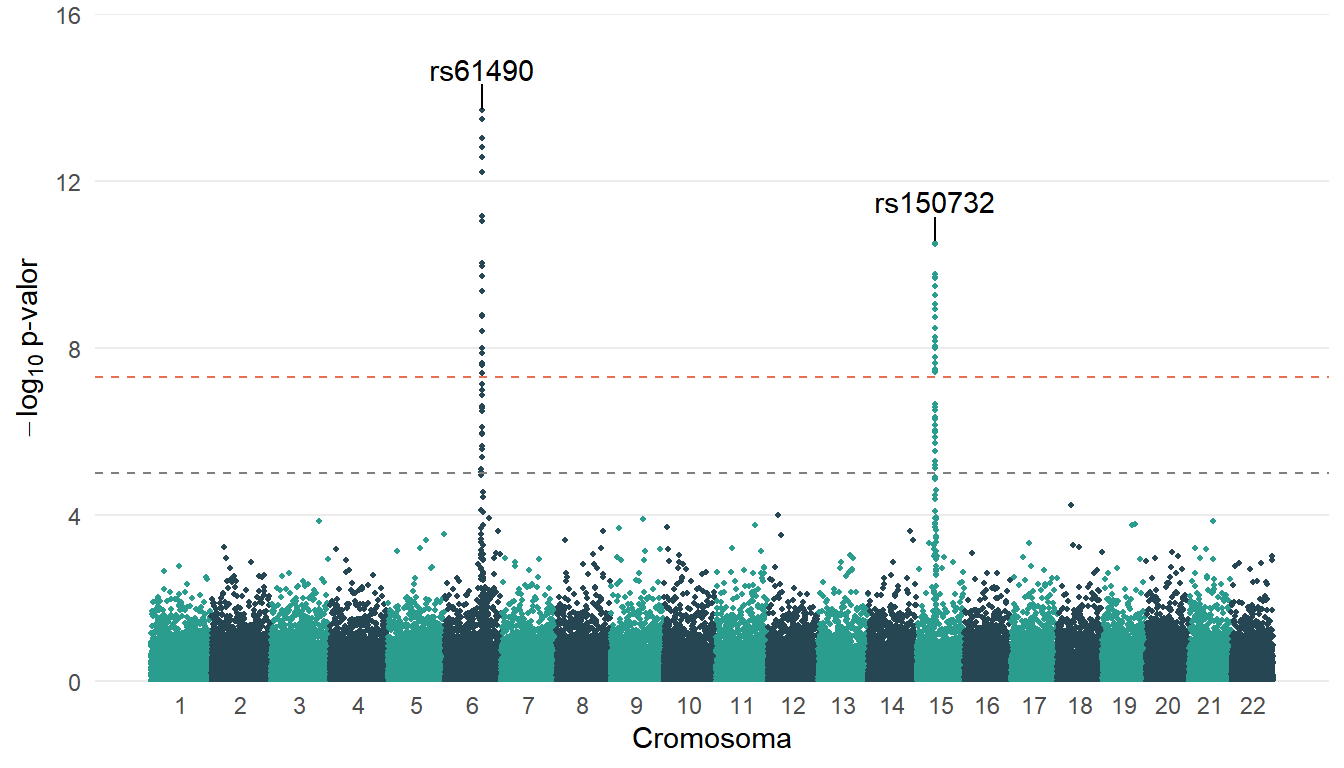
Manhattan plot con qqman
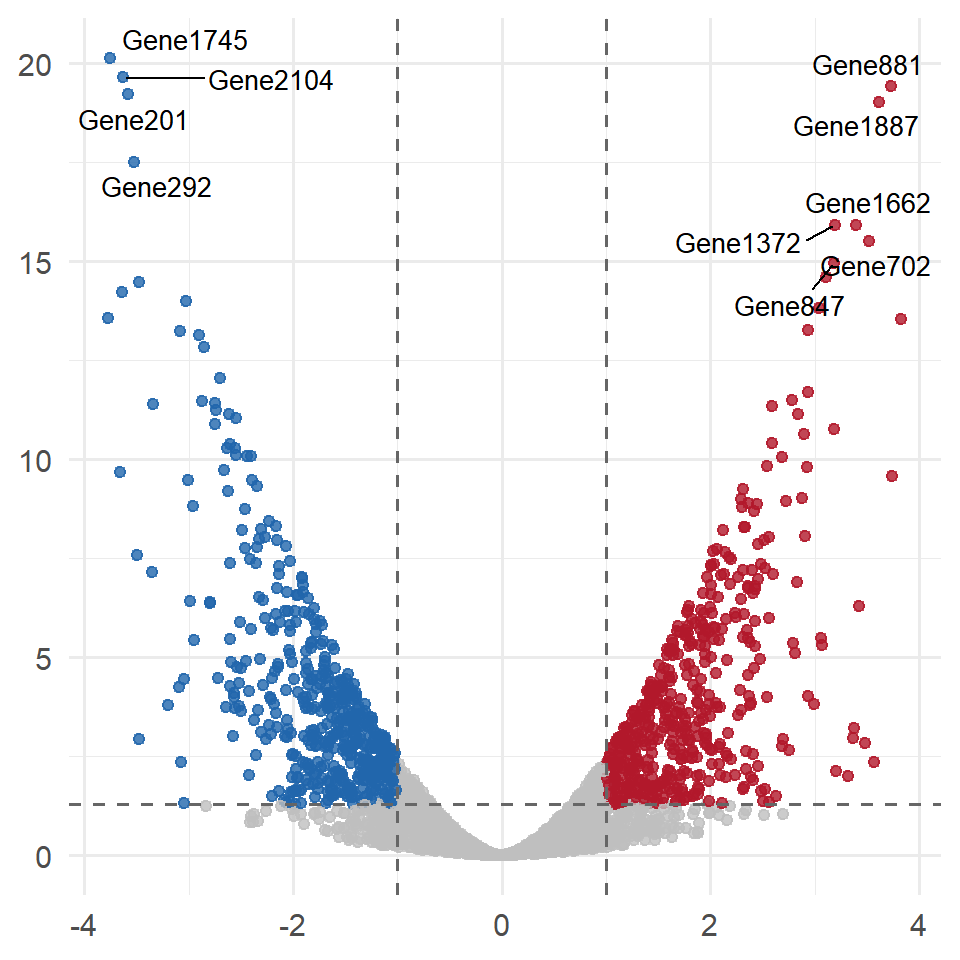
Si necesitas un Manhattan plot rápido también puedes utilizar la función manhattan del paquete qqman, que solo necesita las columnas CHR, BP, P y SNP y añade las líneas de significación automáticamente. Sin embargo, ggplot2 ofrece más flexibilidad para personalizar el resultado. Si lo que necesitas es visualizar los resultados de un análisis de expresión diferencial puedes utilizar un volcano plot.
# install.packages("qqman")
library(qqman)

manhattan(gwas, chr = "CHR", bp = "BP", p = "P", snp = "SNP")
Master Statistics
Aprende estadística desde lo básico hasta técnicas avanzadas, explicado con claridad
Ir al sitio