Datos de muestra
Un volcano plot (gráfico de volcán) es un tipo de gráfico de dispersión que se utiliza para visualizar los resultados de un análisis de expresión diferencial, mostrando a la vez la magnitud del cambio (log2 fold change) en el eje X y la significación estadística (-log10 del p-valor) en el eje Y. Los genes más significativos aparecen en la parte superior y los que tienen cambios más grandes a ambos lados, lo que da al gráfico su característica forma de volcán.
En este tutorial vamos a utilizar un conjunto de datos simulado con la misma estructura que la salida de paquetes como DESeq2 o limma: una columna con el nombre del gen, otra con el log2 fold change y otra con el p-valor. Si trabajas con tus propios resultados solo necesitarás estas columnas.
set.seed(12)
n <- 3000
df <- data.frame(gene = paste0("Gene", 1:n),
                 log2FC = rnorm(n, mean = 0, sd = 1.2))
df$pvalue <- pmin(1, 10^(-(abs(df$log2FC)^1.6) * runif(n, 0.2, 2.5)))
Ten en cuenta que en un análisis real deberías utilizar los p-valores ajustados (por ejemplo, la columna padj de DESeq2) en lugar de los p-valores sin ajustar.
Volcano plot básico
Para crear un volcano plot básico en ggplot2 tendrás que pasar el log2 fold change a x y -log10(pvalue) a y y usar geom_point. La transformación de los p-valores hace que los genes más significativos (los p-valores más pequeños) aparezcan en la parte superior del gráfico.
# install.packages("ggplot2")
library(ggplot2)

ggplot(df, aes(x = log2FC, y = -log10(pvalue))) +
  geom_point()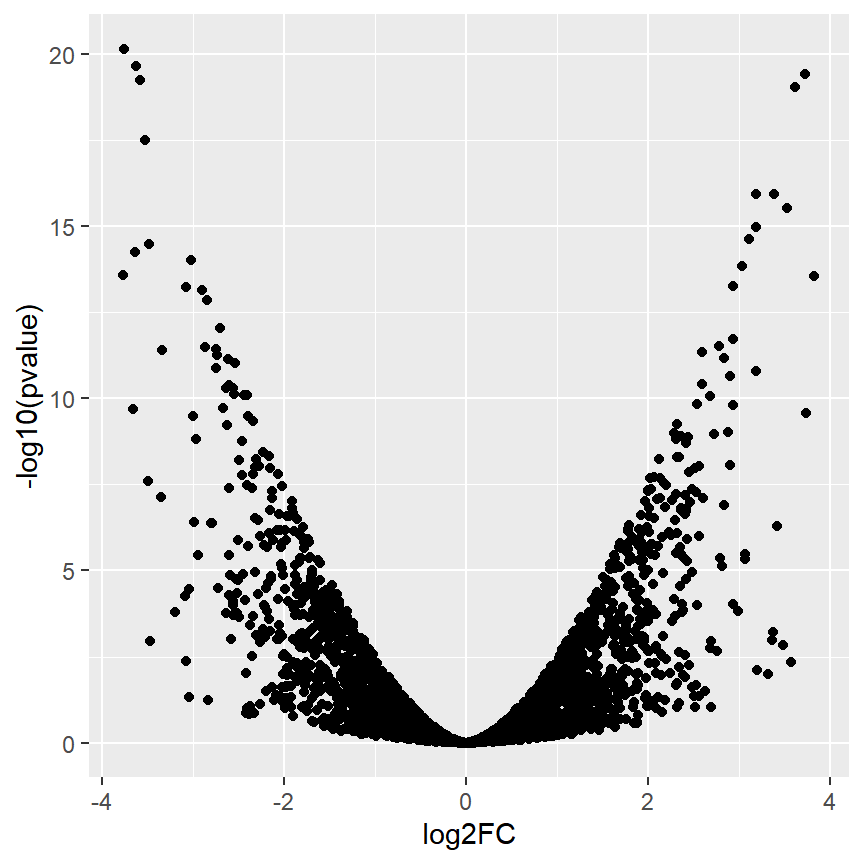
Umbrales de significación
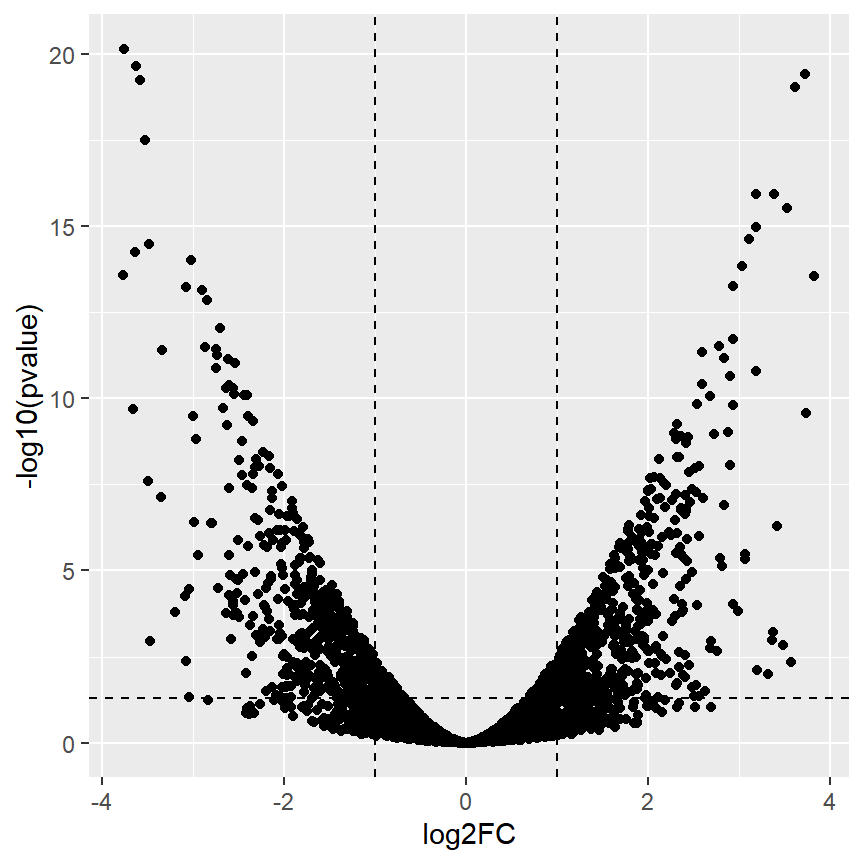
Es habitual añadir líneas de referencia para marcar los umbrales utilizados para considerar que un gen se expresa de manera diferencial. En este ejemplo utilizamos un fold change de 2 (un log2 fold change de -1 y 1) con geom_vline y un p-valor de 0.05 con geom_hline. Ten en cuenta que la línea horizontal se debe colocar en -log10(0.05).
ggplot(df, aes(x = log2FC, y = -log10(pvalue))) +
  geom_point() +
  geom_vline(xintercept = c(-1, 1), linetype = "dashed") +
  geom_hline(yintercept = -log10(0.05), linetype = "dashed")
Colorear los genes sobreexpresados e infraexpresados
La personalización más útil de un volcano plot es colorear los genes significativos. Para ello tendrás que crear una nueva columna que clasifique cada gen como sobreexpresado, infraexpresado o no significativo en base a los umbrales.
df$diffexp <- "No significativo"
df$diffexp[df$log2FC > 1 & df$pvalue < 0.05] <- "Sobreexpresado"
df$diffexp[df$log2FC < -1 & df$pvalue < 0.05] <- "Infraexpresado"
Luego, pasa la nueva columna al argumento color de aes y elige los colores con scale_color_manual, utilizando un vector con nombres para que cada categoría tenga siempre el mismo color. Consulta la guía de colores en ggplot2 para más opciones.
ggplot(df, aes(x = log2FC, y = -log10(pvalue), color = diffexp)) +
  geom_point() +
  geom_vline(xintercept = c(-1, 1), linetype = "dashed") +
  geom_hline(yintercept = -log10(0.05), linetype = "dashed") +
  scale_color_manual(values = c("Infraexpresado" = "#2166AC",
                                "No significativo" = "grey75",
                                "Sobreexpresado" = "#B2182B"))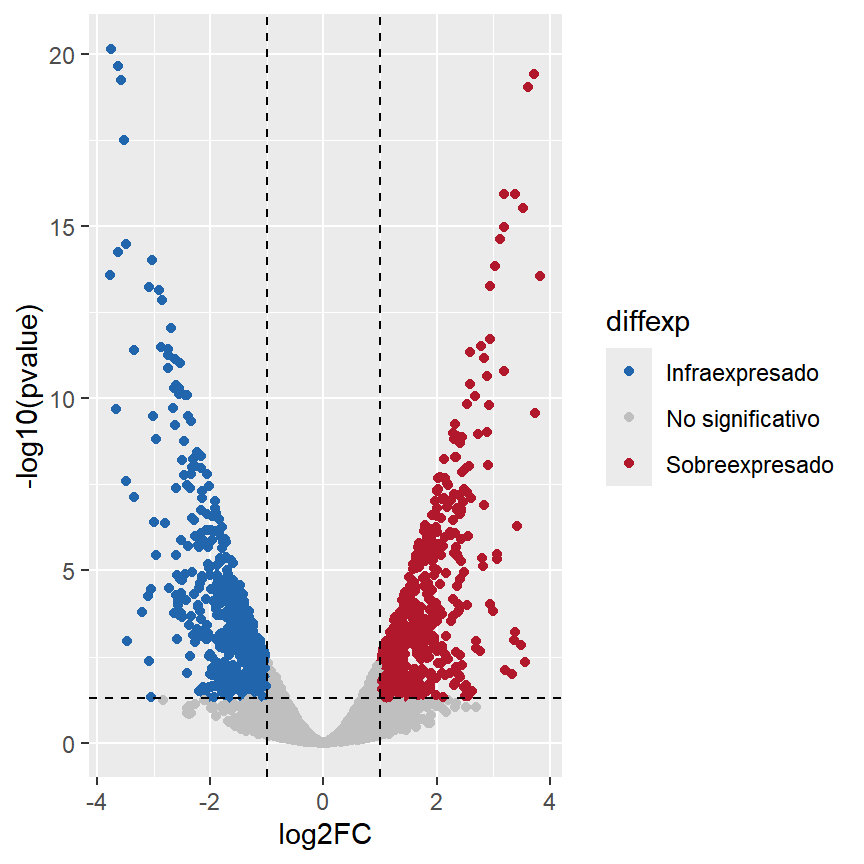
Etiquetar los genes principales
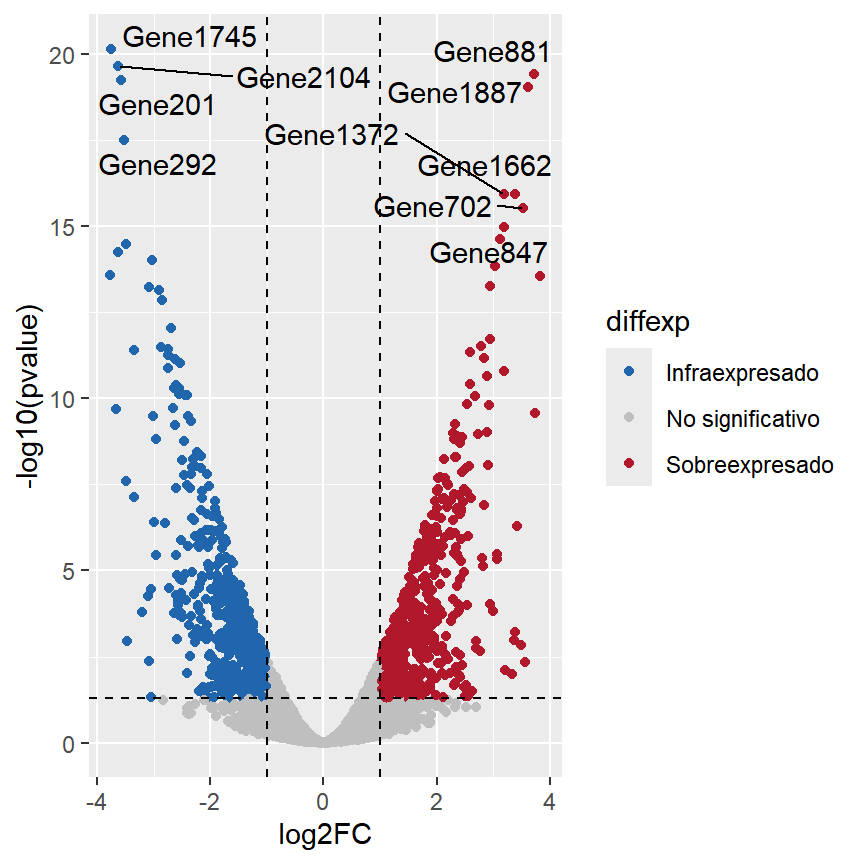
Etiquetar todos los genes haría el gráfico ilegible, por lo que lo habitual es etiquetar solo los genes más significativos. Crea un subconjunto con los genes que quieras etiquetar y pásalo al argumento data de geom_text_repel del paquete ggrepel, que evita que las etiquetas de texto se solapen.
# install.packages("ggrepel")
library(ggrepel)

top_genes <- head(df[order(df$pvalue), ], 10)

ggplot(df, aes(x = log2FC, y = -log10(pvalue), color = diffexp)) +
  geom_point() +
  geom_vline(xintercept = c(-1, 1), linetype = "dashed") +
  geom_hline(yintercept = -log10(0.05), linetype = "dashed") +
  geom_text_repel(data = top_genes, aes(label = gene),
                  color = "black", max.overlaps = Inf) +
  scale_color_manual(values = c("Infraexpresado" = "#2166AC",
                                "No significativo" = "grey75",
                                "Sobreexpresado" = "#B2182B"))
Personalización adicional
Por último, puedes mejorar el aspecto del volcano plot reduciendo el tamaño de los puntos, añadiendo transparencia con alpha para ver los genes que se solapan, cambiando el tema y estableciendo títulos de los ejes más descriptivos. Ten en cuenta que expression permite escribir los subíndices de los títulos de los ejes.
ggplot(df, aes(x = log2FC, y = -log10(pvalue), color = diffexp)) +
  geom_point(size = 1.5, alpha = 0.7) +
  geom_vline(xintercept = c(-1, 1), linetype = "dashed") +
  geom_hline(yintercept = -log10(0.05), linetype = "dashed") +
  geom_text_repel(data = top_genes, aes(label = gene),
                  color = "black", max.overlaps = Inf) +
  scale_color_manual(values = c("Infraexpresado" = "#2166AC",
                                "No significativo" = "grey75",
                                "Sobreexpresado" = "#B2182B")) +
  theme_minimal() +
  theme(legend.position = "bottom") +
  labs(x = expression(log[2]~fold~change),
       y = expression(-log[10]~"p-value"),
       color = NULL)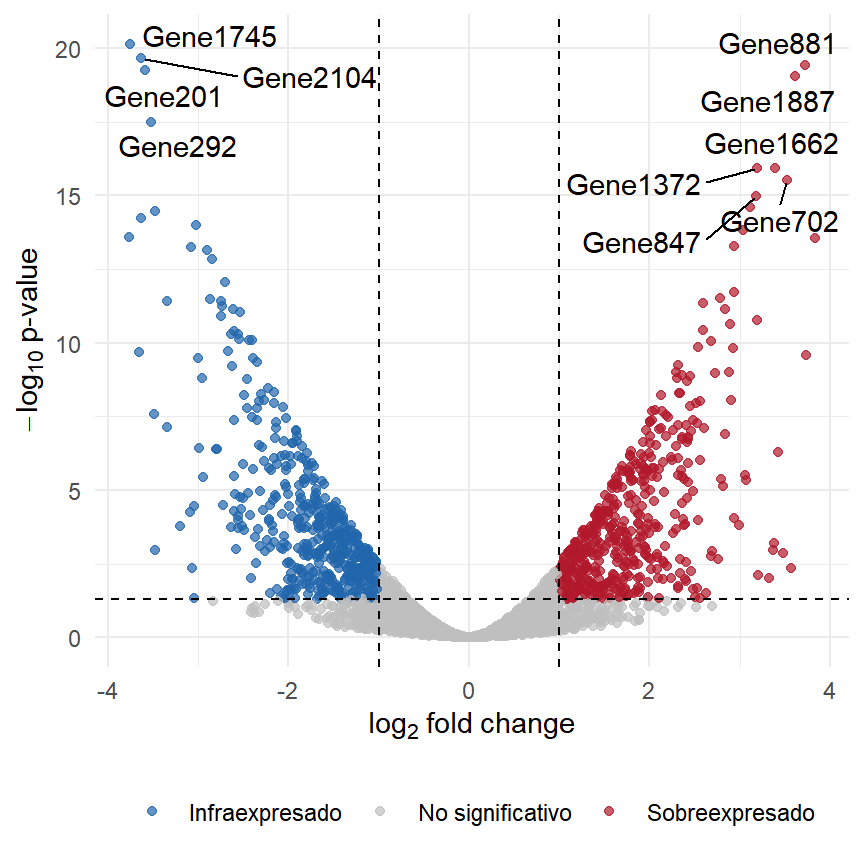
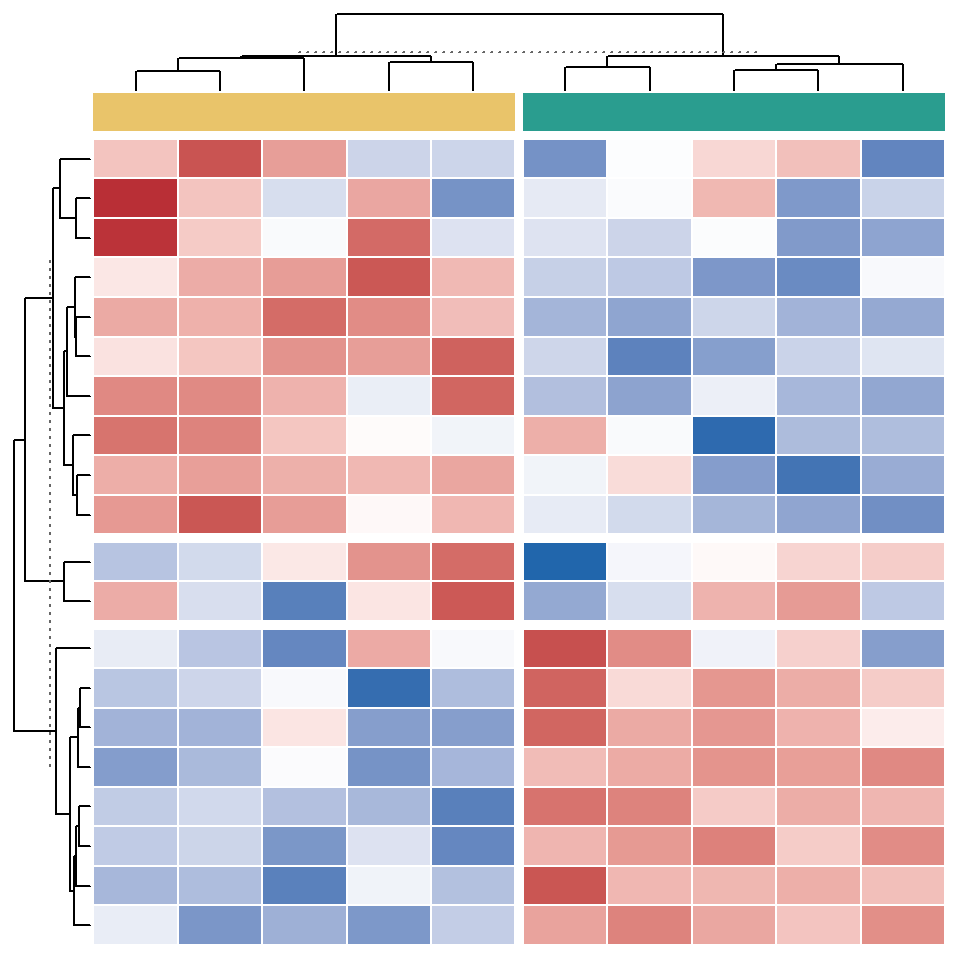
Una vez identificados los genes con expresión diferencial puedes visualizar su expresión en las distintas muestras con un mapa de calor con clusters.
Master Statistics
Aprende estadística desde lo básico hasta técnicas avanzadas, explicado con claridad
Ir al sitio